Практические разборы, рецепты и инструменты по LLM и агентам: о чём статья, ключевой инженерный вывод и что можно запустить и проверить за один вечер.
🗓 окно 14 — 21 сентября 2026⚡ статей: 10👀 на заметку: 5📡 отсканировано: 237🎯 в дайджест: 15
📝 О чём пишут на этой неделе
На этой неделе инженерное сообщество HackerNoon сфокусировалось на уходе от облачных монополий к локальной и экономной агентной разработке. Разработчики переносят Claude Code и Codex на собственные серверы с Ollama и DeepSeek, отсекая абонентские платы и сохраняя конфиденциальность кодовых баз. Одновременно сместился фокус безопасности: логи выполнения и трейсы агентов признаны новым внешним периметром утечки данных, а изоляция контекста в монорепозиториях и нормализация схем БД стали критичнее апгрейда самих моделей.
⚡
Главные статьи недели
01
Запуск Claude Code за $0: рабочий сетап с локальным сервером Ollama
Практическая инструкция по перенаправлению CLI-агента Claude Code с платных серверов Anthropic на локальный инференс через движок Ollama. Автор разбирает технический переход Messages API на локальный порт и показывает, как устранить скрытые сбои вызова инструментов.
🔑 Главное
Ollama поддерживает формат Anthropic Messages API, поэтому для базовой переадресации достаточно переменных ANTHROPIC_BASE_URL=http://localhost:11434 и ANTHROPIC_AUTH_TOKEN=ollama.
Критический баг фонового роутинга: Claude Code жестко запрашивает системные градации моделей (Haiku/Sonnet/Opus). Без явного переопределения переменных ANTHROPIC_DEFAULT_HAIKU_MODEL, ..._SONNET_MODEL и ..._OPUS_MODEL запросы молча падают при запуске сабагентов.
Для стабильной кодогенерации рекомендованы веса Qwen2.5-Coder 7B (для 8 ГБ RAM) и Qwen 30B / Devstral 24B (для 24+ ГБ VRAM) с флагами OLLAMA_FLASH_ATTENTION=1 и квантованием KV-кэша q8_0.
Дыра подхода: в локальном Ollama отсутствует серверный Prompt Caching; модели менее 14B на длинных агентных сессиях теряют контекст и ломают формат JSON при вызове инструментов.
⚡ Попробовать за вечер
Установить свежий Ollama, скачать модель ollama pull qwen2.5-coder:7b и запустить сервер ollama serve.
Экспортировать переменные перенаправления базы URL и назначить локальную модель на все три тира (Haiku, Sonnet, Opus), после чего запустить сессию claude в тестовом репозитории.
Метрика: агент выполняет чтение локального файла и генерирует рабочий тест без сетевых обращений к api.anthropic.com (проверяется через tcpdump или lsof).
Архитектура локального перенаправления Claude Code в рантайм Ollama без обращения в облако
Практический каркас CLAUDE.md: 7 секций, лимит 200 строк и отказ от запретов
✍ Xi YangHackerNoon⏱ ≈7 минclaude-codeagentsprompt-engineering
О чём
Инструкция по проектированию корневых файлов контекста CLAUDE.md и AGENTS.md. Автор доказывает, что разрастание инструкций ухудшает качество рассуждений модели, и предлагает жесткую модульную декомпозицию инструкций.
🔑 Главное
Ограничение объема: рабочий файл не должен превышать 200 строк. Избыток контекста сжигает бюджет токенов на каждом шаге и провоцирует галлюцинации.
Каноническая 7-блочная структура: Однострочное назначение, Архитектурные инварианты, Стек технологий, Консольные команды, Неявные конвенции, Границы правок (Boundaries), Карта доменной документации.
Отказ от раздела «Never»: списки прошлых инцидентов превращаются в разрастающееся кладбище правил, которое модель игнорирует. Любой запрет следует формулировать как позитивное правило архитектуры.
Дыра подхода: в статье нет замеров на публичных бенчмарках кодогенерации, а строгий отказ от негативных запретов рискован при блокировке деструктивных операций (прямой пуш в production).
⚡ Попробовать за вечер
Сгенерировать черновик с помощью claude /init и сократить его до 150 строк, выделив блок границ файлов (Boundaries).
Вынести правила тестирования в отдельный файл .claude/rules/tests.md с метаданными путей paths: ["tests/**/*.py"].
Метрика: агент подгружает правила тестирования строго при изменении тестовых файлов, не расходуя токены при правке документации или UI.
Декомпозиция базового контекста CLAUDE.md на изолированные модули правил с таргетингом путей
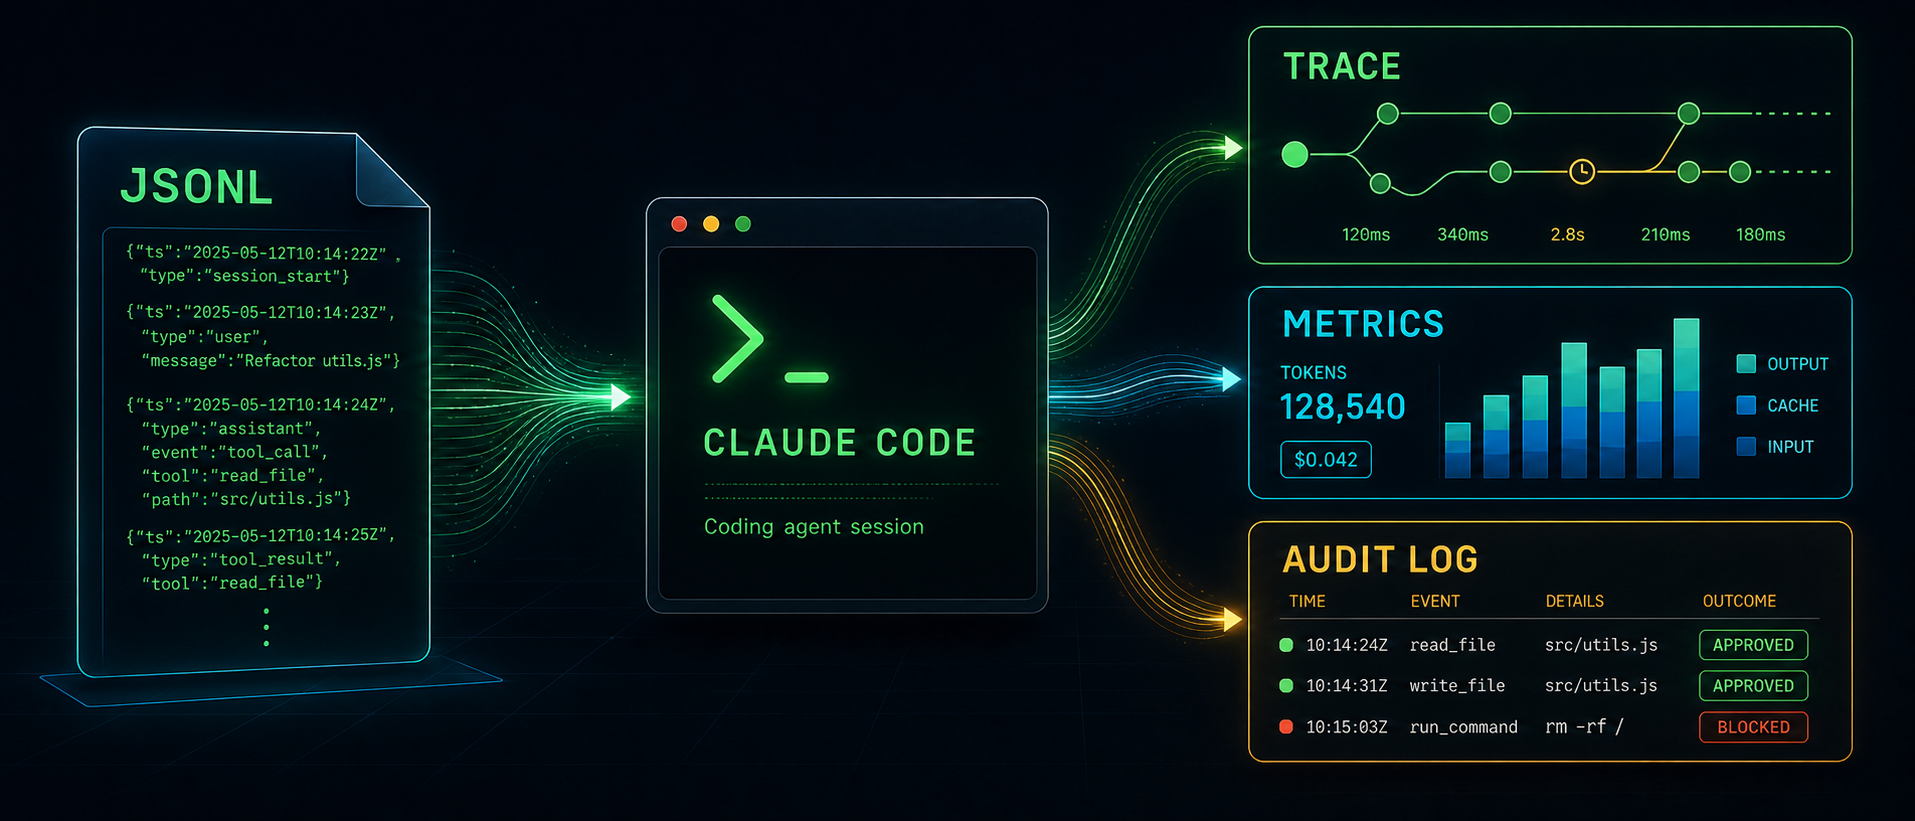
Детальный разбор телеметрии Claude Code CLI: исследование локальных файлов сессий с помощью jq и настройка полномасштабного экспорта логов, метрик и распределенных трейсов в OpenTelemetry-совместимые бэкенды.
🔑 Главное
Каждая локальная сессия автоматически сохраняется в формате JSONL по пути ~/.claude/projects/<project>/<sessionId>.jsonl без необходимости поднимать коллекторы.
Для подсчета суммарных output-токенов сессии достаточно однострочника jq -s '[.[] | select(.type=="assistant") | (.message.usage.output_tokens // 0)] | add' session.jsonl.
Экспорт в OTel включается через CLAUDE_CODE_ENABLE_TELEMETRY=1 и передает метрики стоимости, использования кэша токенов и событий принятия патчей (claude_code.code_edit_tool.decision).
Дыра подхода: Claude Code не пробрасывает переменные окружения OTEL_* в запускаемые bash-подпроцессы, хуки и MCP-серверы, что разрывает сквозную цепочку трейса без явной настройки W3C traceparent.
⚡ Попробовать за вечер
Найти файл последней сессии в ~/.claude/projects/ и отфильтровать хронологию вызовов инструментов командой jq из статьи.
Запустить сессию с выводом OTel-метрик в консоль: CLAUDE_CODE_ENABLE_TELEMETRY=1 OTEL_METRICS_EXPORTER=console claude.
Метрика: в консоли терминала ежесекундно печатаются структуры метрик с атрибутами модели, стоимостью в USD и количеством созданных/прочитанных токенов кэша.
from article
На схеме: Поток телеметрии от сырого JSONL до распределенных трейсов, метрик токенов и аудит-лога вызовов инструментов
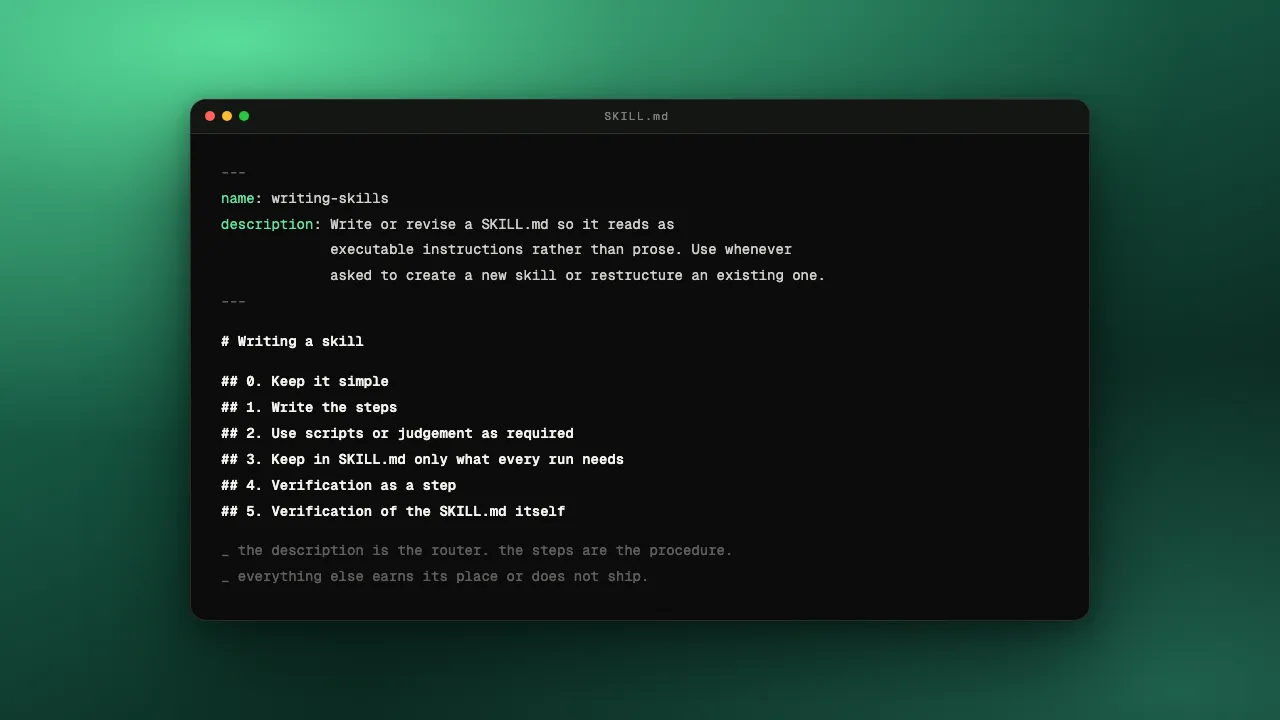
Методология создания надежных агентных процедур на основе открытого каталога EthicalML. Автор объясняет, как превратить разрозненные shell-скрипты в структурированные навыки, сохраняя баланс между детерминированным кодом и суждениями LLM.
🔑 Главное
Описание навыка в YAML frontmatter работает как семантический роутер: формулировать триггеры нужно терминами запросов пользователя, а не абстрактным описанием программы.
Тело навыка содержит исключительно шаги исполнения; любые объяснительные разделы (Overview, Rationale, Architecture) безжалостно удаляются для экономии контекста.
Детерминированные последовательности (авторизация, вызовы API) выносятся в bash-скрипты, а логические решения и оценка результатов доверяются агенту.
Дыра подхода: концепция маховика обратной связи (агент сам отправляет PR с правками в репозиторий навыка при затруднениях) на практике генерирует паразитный шум от галлюцинаций слабых моделей.
Анализ рисков компрометации данных через журналы исполнения агентов. Автор тестирует открытый инструмент agent-inspect и формулирует модель угроз, доказывая, что локальное хранение трейсов не защищает от утечек API-ключей и PII.
🔑 Главное
Трейс агента фиксирует полный снимок промптов, файлов, параметров тулов и бизнес-правил, превращаясь в критический вектор атаки наравне с бэкапами баз данных.
Модель угроз охватывает 5 фаз: вызов модели адаптером, сброс логов на диск, хранение артефактов в CI, публикация разработчиком и чтение данных внешними MCP-клиентами.
Команда маскирования agent-inspect redact создает производную очищенную копию (share.jsonl), не изменяя оригинал; к исходному файлу обязателен доступ с правами chmod 600.
Дыра подхода: регулярные выражения и профили маскирования бессильны против семантических утечек и промпт-инъекций, спрятанных внутри свободного текста диалога.
⚡ Попробовать за вечер
Клонировать репозиторий agent-inspect, переключиться на релиз agent-inspect@6.17.4 и собрать проект через pnpm.
Метрика: команда npx agent-inspect verify-safe demo-pii --explain выявляет все незамаскированные токены авторизации и почтовые адреса с генерацией структурированного отчета.
Пять границ перехода данных при генерации, локальном хранении и экспорте агентных трейсов
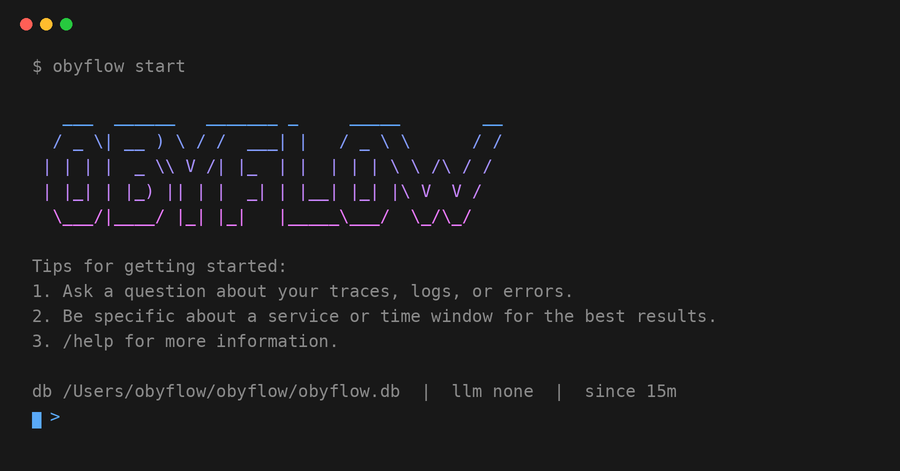
Разбор архитектуры открытого CLI-инструмента Obyflow для локальной отладки LLM и RAG-пайплайнов. Автор демонстрирует, как заменить абстрактные текстовые логи строгой статистической диагностикой и верификацией улик без участия нейросети.
🔑 Главное
Вместо неструктурированного текста инструмент собирает 10 строго типизированных событий (vector_op со скорами сходства, llm_call, chain, tool_call).
Детерминированная оценка уверенности: уровень доверия к диагнозу рассчитывается по формуле от объема улик и z-score отклонений метрик, а не генерируется LLM.
Функция validateEvidenceGrounding проверяет все ссылки модели evidence_refs на принадлежность к реально собранному набору данных, механически выявляя выдуманные цитаты.
Дыра подхода: асимметрия алгоритмов обнаружения аномалий — ядро на TypeScript рассчитывает скользящие окна и z-score, а Python-пакет использует IsolationForest, что приводит к разным порогам в гетерогенном стеке.
⚡ Попробовать за вечер
Установить CLI-пакет npm i -g obyflow, выполнить npx obyflow init и запустить локальный сервер со встроенной SQLite.
Подключить мидлварь @obyflow/node или Python-пакет к RAG-пайплайну на базе LangChain или Pinecone.
Метрика: запуск npx obyflow investigate --no-llm мгновенно локализует падение сходства векторов без отправки данных во внешние API.
from article
В терминале: Запуск локального демона Obyflow: автоматическое создание SQLite базы без внешних облачных зависимостей
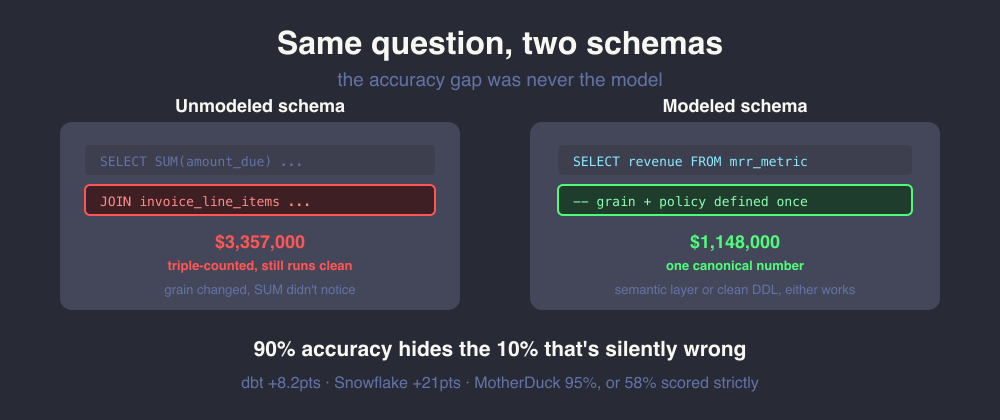
Критический анализ бенчмарков генерации SQL языковыми моделями. Автор доказывает, что синтаксически валидный SQL часто выдает ложные цифры из-за изменения гранулярности таблиц при объединениях, а базовая нормализация схемы дает прирост точности в 25 процентных пунктов.
🔑 Главное
Ловушка гранулярности: при запросе выручки модель задваивает и затраивает суммы ($1,148,000 превращается в $3,357,000), потому что выполняет JOIN таблицы счетов с позициями заказов и суммирует заголовочные поля.
В тестах dbt Labs моделирование схемы подняло точность ответов с 64.5% до 90.0% на одной и той же модели, тогда как добавление семантического слоя прибавило всего 8 пунктов.
Бенчмарк MotherDuck (95% на чистом DDL) в строгих условиях BIRD-SQL падает до 58–64%: победные отчеты вызваны снисходительностью LLM-судей к неточным формулировкам.
Дыра подхода: совет перемоделировать все таблицы неприменим к enterprise-хранилищам на тысячи таблиц; авторы советуют нормализовать только срезы под 5–10 ключевых бизнес-метрик.
⚡ Попробовать за вечер
Выполнить тест расхождения гранулярности: сгенерировать расчет агрегата из мастер-таблицы и через JOIN со связанной детальной таблицей.
Сформулировать смысл строки (табличный grain) для 5 ключевых таблиц базы и внести их в COMMENT ON TABLE.
Метрика: процент корректных джойнов у кодинг-ассистента увеличивается минимум на 20% без смены промпта.
from article
На схеме: Иллюзия рабочего SQL: утроение суммы ($3.35M вместо $1.15M) на сырых таблицах против однозначного ответа на моделированной схеме
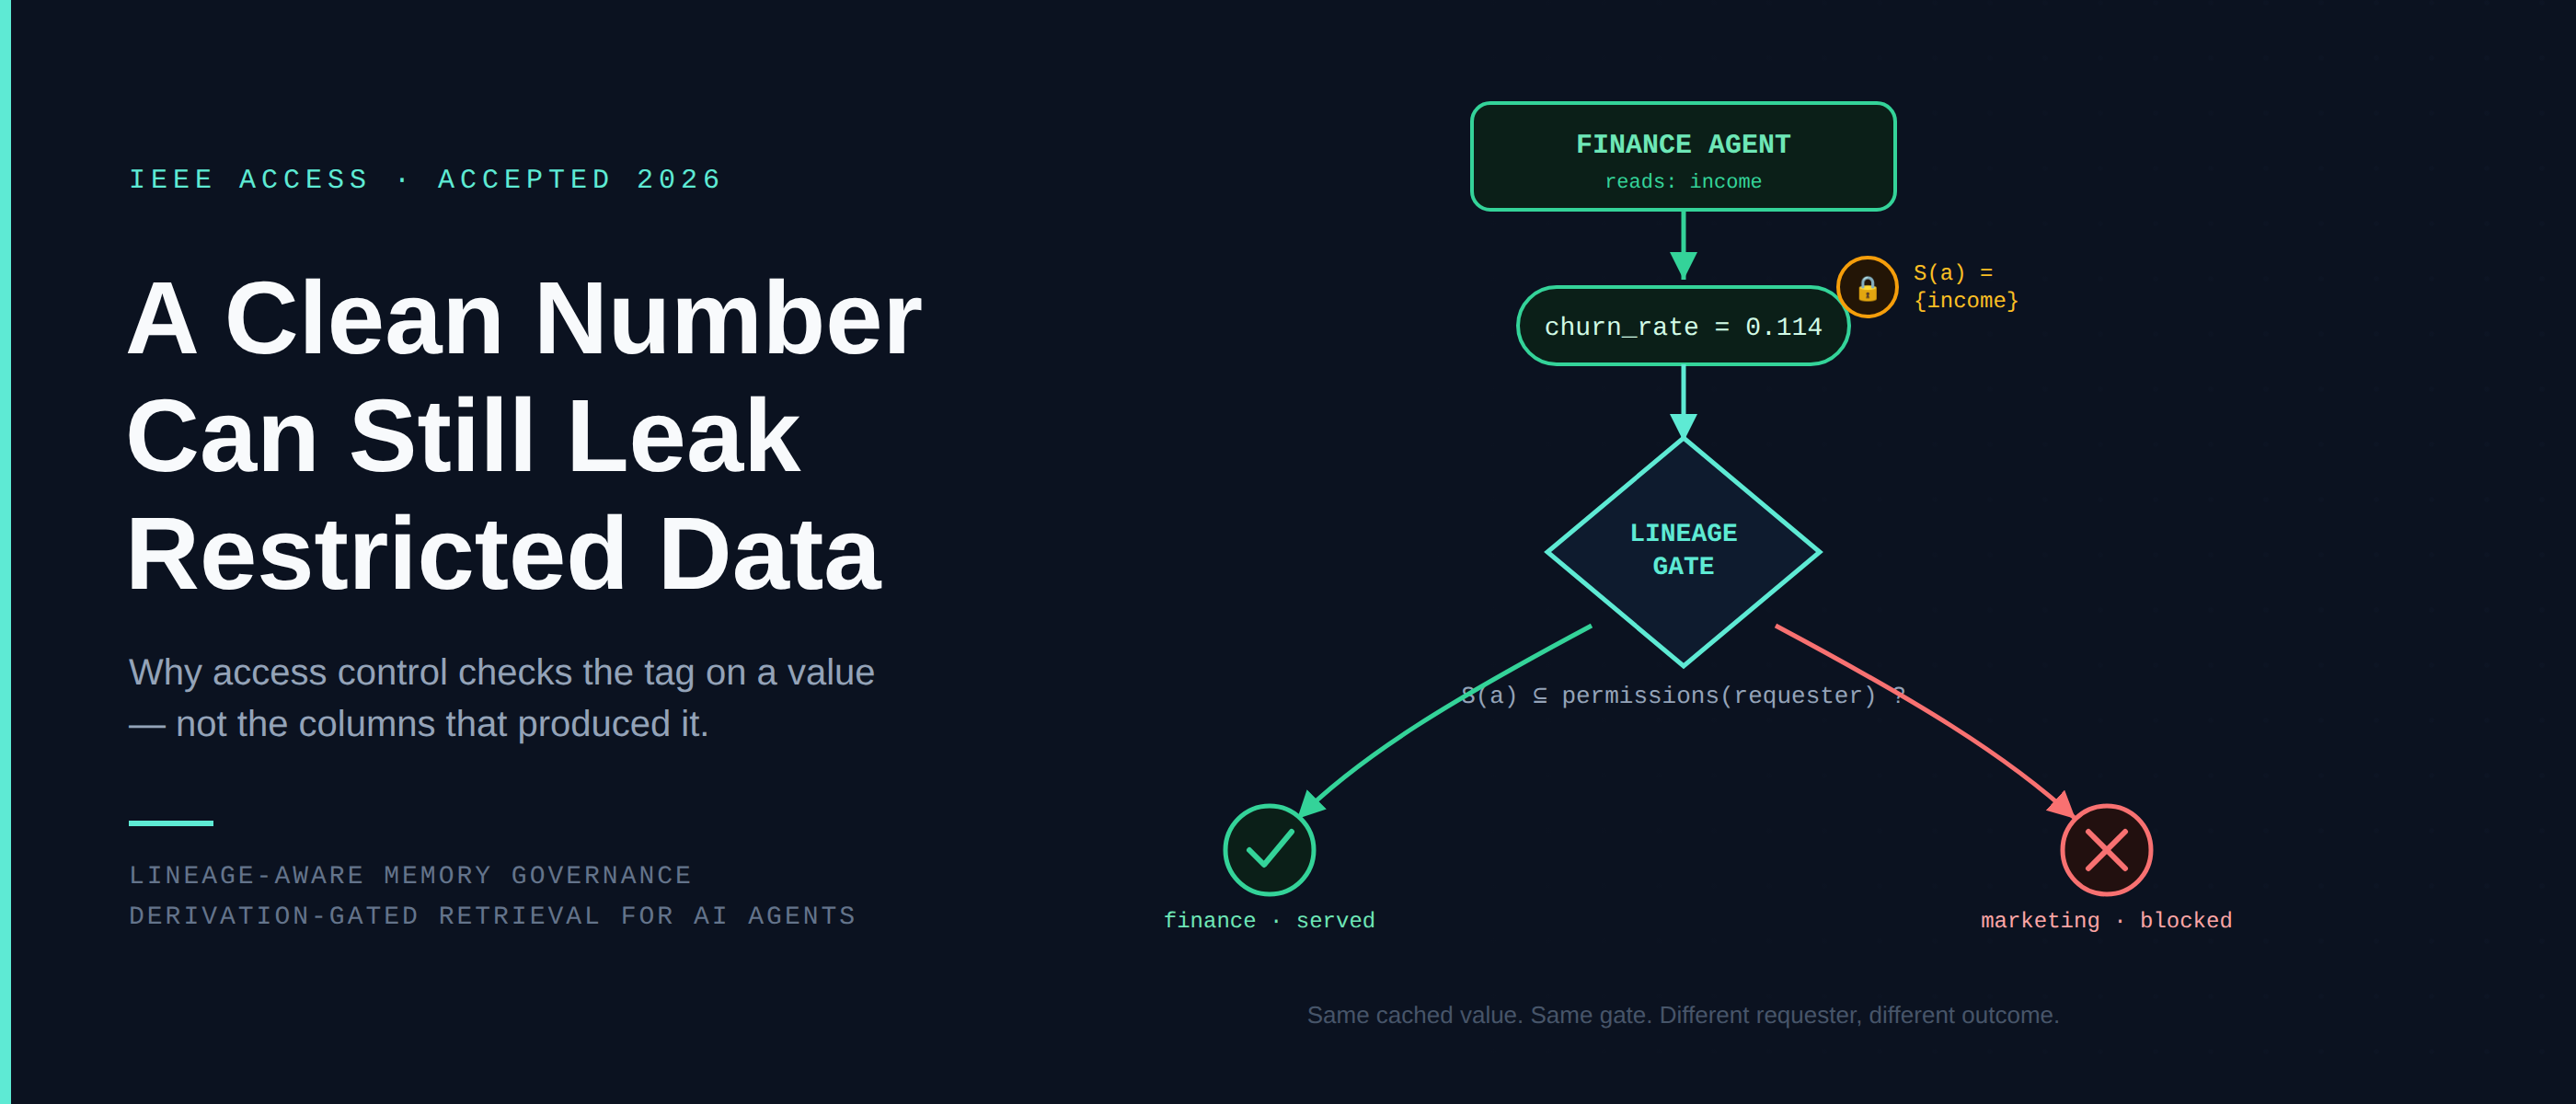
Разбор фундаментальной уязвимости в архитектурах общей памяти мультиагентных систем. Автор объясняет, как кэширование производных метрик позволяет неавторизованным агентам обходить строгие политики разграничения прав доступа к СУБД.
🔑 Главное
Уязвимость кэша: если агент Finance вычислил показатель оттока со ссылкой на защищенную колонку доходов и сохранил число 0.114, агент Marketing может запросить этот кэш напрямую. Запрос к БД не выполняется, и RBAC базы данных не срабатывает.
Решение AMU (Analytical Memory Unit): при записи в память фиксируется не только значение, но и перечень прочитанных колонок и хэш дефиниции запроса.
При отдаче значения из кэша драйвер проверяет условие: columns_touched ⊆ permissions(requester). Время проверки составляет 0.09–13.8 микросекунд и снижает утечки до 0.0%.
Дыра подхода: метод не спасает от косвенных атак восстановления распределения и расчетов, выполненных агентом на локальном Python вне перехватываемого SQL-драйвера.
⚡ Попробовать за вечер
Установить библиотеку pip install sqlglot и написать middleware-перехватчик, извлекающий имена колонок из AST дерева SELECT-запросов.
Смоделировать общий кэш с двумя ролями и проверить блокировку отдачи вычисленной метрики при отсутствии прав на базовую колонку.
Метрика: попытка чтения производного кэша неавторизованным агентом возвращает 100% контролируемый отказ вместо тихого слива цифры.
from article
На схеме: Lineage Gate: проверка прав доступа к исходным колонкам данных при запросе вычисленного значения из кэша памяти
Практический рецепт интеграции API DeepSeek в качестве основной модели для кодинг-агента ChatGPT Codex. Автор показывает точные конфигурационные файлы TOML и JSON, позволяющие отказаться от фиксированной ежемесячной подписки.
🔑 Главное
Настройка провайдера в ~/.codex/config.toml: указание base_url = "https://api.deepseek.com" и переменной env_key = "DEEPSEEK_API_KEY".
Регистрация модели в каталоге ~/.codex/models.json с контекстным окном в 1 048 576 токенов, параллельными вызовами инструментов и политикой обрезки контекста.
Экономический эффект: недельный расход разработчика (500k input / 100k output токенов) обходится в ~$0.18 на DeepSeek-V4-Flash против ~$1.63 на frontier-моделях.
Дыра подхода: прямая зависимость от аптайма серверов DeepSeek и трансграничных задержек сетевых пакетов при пиковых нагрузках.
⚡ Попробовать за вечер
Получить API-ключ в консоли DeepSeek и добавить экспорт export DEEPSEEK_API_KEY=... в профиль shell.
Скопировать манифест модели в ~/.codex/models.json и перезапустить клиент Codex CLI.
Метрика: в правом нижнем углу интерфейса Codex отображается активная модель DeepSeek-Flash, успешно исполняющая поиск по файлам.
Схема переключения рантайма Codex CLI на экономный API DeepSeek с сохранением тулзов
Практический опыт реорганизации фронтенд-кодовой базы под требования кодинг-ассистентов Cursor и Claude Code. Автор показывает, как монорепозиторий и строгая изоляция микрофронтендов предотвращают раздувание контекста и архитектурную эрозию.
🔑 Главное
Монорепозиторий (Turborepo + pnpm) устраняет необходимость скачивания чужих репозиториев: агент работает только с локальным модулем и зависимыми пакетами через workspace:*.
Запрет горизонтальных связей: модули (module-orders и module-catalog) изолированы друг от друга и соединяются только вертикально через хост-приложение shell и общие пакеты packages/ui, utils.
Многоуровневый AGENTS.md: разделение правил на глобальные конвенции (.rules/always/) и контекстные (.rules/packages/analytics.md), подгружаемые только при правке соответствующих файлов.
Дыра подхода: отказ от горизонтальных связей требует жесткого версионирования общих внутренних пакетов во избежание блокирующих каскадных правок.
⚡ Попробовать за вечер
Разбить правила проекта на папки .rules/always и .rules/packages вместо одного монолитного файла.
Настроить промпт для задачи со строгим указанием пути: «Работай только внутри apps/module-catalog, используй кнопку из packages/ui и правила из .rules/packages/analytics.md».
Метрика: агент завершает задачу за один шаг без создания дублирующих утилит и без попыток импорта соседних бизнес-модулей.
Вертикальная архитектура модулей в монорепозитории: строгая изоляция контекста агентов
Стандартный chrome-devtools-mcp перегружает контекст модели полным сетевым дампом. Разбор прямого перехвата через Chrome DevTools Protocol и фильтрация ответов по URL и статусу экономят до 9 раз больше токенов при проверке сбоев API.
Постмортем рекомендателя CineGeist: попытка отбирать неожиданный контент по косинусу ниже 0.35 провалилась, так как неотрицательные эмбеддинги сжаты в конус со сходством 0.50–0.90. Порог лежал за пределами физического распределения данных.
Анализ кризиса ревью в open source проектах (кейс Ghostty): когда агенты создают PR со скоростью инференса, бутылочное горлышко смещается на людей. Спасают только строгие AGENTS.md, изоляция сред и перекрестная проверка агентами.
При больших правках синтаксически корректный код агента незаметно ломает распределение признаков. Автор предлагает заставлять агентов оформлять код в инспектируемые пайплайны ml-pipes с фиксацией промежуточных тензоров.
Мутационный аудит SWE-ABS показал, что каждая пятая задача из бенчмарка засчитывается как решенная только потому, что исходные тесты не покрывают граничные случаи. При усилении тестов лидерборд теряет от 10 до 17 процентных пунктов.
Три конкретных действия по материалам выпуска, которые дадут немедленный эффект в разработке.
Локальный сетап Claude Code: настроить экспорт ANTHROPIC_BASE_URL на Ollama и ремаппинг всех трех тиров моделей на Qwen2.5-Coder для автономной работы без затрат API.
до среды
Рефакторинг CLAUDE.md: сократить базовый файл проекта до 150 строк, вырезать накопившиеся запреты "Never" и настроить таргетированные правила в .claude/rules.
до четверга
Аудит кэша мультиагентов: проверить точки чтения общих агрегатов памяти на соответствие правам доступа к исходным колонкам базы данных.
до субботы
#
Метаданные выпуска
сгенерировано 2026-09-21T07:20:00+03:00
окно сбора 2026-09-14 — 2026-09-21 (7 дней)
отсканировано / в дайджест 237 / 15 (10 основных карточек + 5 на заметку)
источник данных HackerNoon Search Index (Algolia stories, неделя целиком без выборки по тегам)